NobleProg ofrece cursos de capacitación en Big Data en Lèon, brindando a los profesionales de la región la oportunidad de actualizar sus competencias. Al situarse en esta zona estratégica, nuestros programas permiten a los equipos locales adquirir habilidades prácticas y certificadas. Esta inversión en formación fomenta la innovación y el crecimiento profesional, fortaleciendo el talento humano en Big Data.
Los cursos en vivo dirigidos por un instructor de Big Data, disponibles en modalidad online o presencial, comienzan con una introducción a los conceptos elementales de Big Data y luego avanzan hacia los lenguajes de programación y metodologías utilizados para realizar el Análisis de Datos. Se discuten, comparan e implementan en sesiones prácticas de demostración las herramientas e infraestructura habilitadoras para el almacenamiento de Big Data, el Procesamiento Distribuido y la Escalabilidad.
La capacitación en Big Data está disponible como "formación en vivo online" o "formación en vivo presencial". La formación en vivo online (también conocida como "formación remota en vivo") se lleva a cabo mediante un escritorio remoto interactivo. La formación en vivo presencial se puede realizar localmente en las instalaciones del cliente en Lèon o en los centros de formación corporativos de NobleProg ubicados en Lèon.
NobleProg -- Su proveedor local de formación
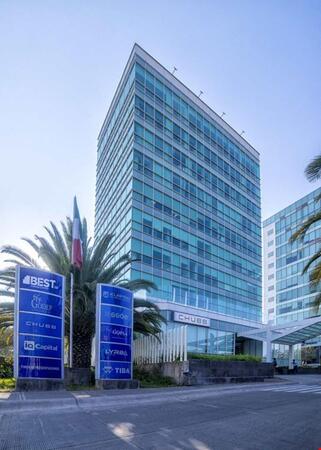
Leòn - Torre San Mateo
Blvd. Campestre 2502, Leòn, México
Ubicada en la Zona Dorada de Leon Gto.
En autobús público
El transporte público de León es el sistema SIT/Optibús. La ciudad publica información actualizada sobre las rutas y los horarios a través de su Departamento de Movilidad.
Desde el centro de León: una opción práctica es viajar hacia la Terminal San Jerónimo y luego continuar hacia la zona de Campestre.
El Blvd. Campestre cuenta con servicio de rutas locales; por ejemplo, la ruta L-02 recorre el Boulevard Campestre y conecta con el Centro Histórico y San Jerónimo.
Para el tramo final, es posible que tenga que caminar unos minutos desde la parada más cercana hasta el n.º 2502.
Esta formación en vivo dirigida por instructores en <ubic> (en línea o presencial) está orientada a científicos de datos e ingenieros de nivel intermedio que desean utilizar Google Colab y Apache Spark para el procesamiento y análisis de big data.
Al finalizar esta formación, los participantes podrán:
Configurar un entorno de big data utilizando Google Colab y Spark.
Procesar y analizar grandes conjuntos de datos de forma eficiente con Apache Spark.
Visualizar big data en un entorno colaborativo.
Integrar Apache Spark con herramientas basadas en la nube.
Esta formación en vivo con instructor en Lèon cubre la plataforma Stratio, enfocándose en los módulos Rocket e Intelligence con PySpark. Los participantes dominarán la ingesta, transformación y analítica avanzada de datos, adquiriendo habilidades prácticas en bucles, UDFs y flujos de trabajo de datos empresariales.
Esta capacitación en vivo en Lèon cubre conceptos de almacenamiento de datos, modelado dimensional y diseño de pipelines ETL. Los participantes construirán esquemas de estrella, optimizarán cargas de trabajo OLAP e implementarán gobernanza, adquiriendo habilidades prácticas para crear sistemas analíticos sólidos.
Los participantes que completen esta capacitación en vivo con instructores en Lèon obtendrán una comprensión práctica y del mundo real sobre Big Data, así como de sus tecnologías, metodologías y herramientas relacionadas.
Los participantes tendrán la oportunidad de aplicar estos conocimientos mediante ejercicios prácticos. La interacción grupal y la retroalimentación del instructor son componentes fundamentales de esta clase.
El curso comienza con una introducción a los conceptos elementales de Big Data, avanza hacia los lenguajes de programación y las metodologías utilizadas para realizar análisis de datos y, finalmente, aborda las herramientas e infraestructura que permiten el almacenamiento de Big Data, el procesamiento distribuido y la escalabilidad.
Esta capacitación en vivo en Lèon ayuda a los usuarios de nivel intermedio a avanzado a dominar la arquitectura de Greenplum y el modelado de datos. Los participantes aprenderán a diseñar tablas distribuidas, aplicar SQL de alto rendimiento e interpretar planes EXPLAIN para una ejecución óptima de consultas en entornos analíticos a gran escala.
Esta capacitación en Lèon dirigida por un instructor cubre la instalación de Greenplum, actualizaciones y gestión de bibliotecas. Los participantes aprenden a configurar clústeres, aplicar parches de forma segura y manejar extensiones para el análisis avanzado, desarrollando habilidades prácticas para entornos reales.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a profesionales de los datos de nivel avanzado que desean optimizar sus flujos de trabajo de procesamiento de datos, garantizar la integridad de los mismos e implementar soluciones robustas de lago de datos tipo lakehouse capaces de manejar las complejidades de las aplicaciones modernas de big data.
Al finalizar esta formación, los participantes serán capaces de:
Comprender en profundidad la arquitectura de Iceberg, incluida la gestión de metadatos y el diseño de archivos.
Configurar Iceberg para un rendimiento óptimo en distintos entornos e integrarlo con múltiples motores de procesamiento de datos.
Gestionar tablas Iceberg a gran escala, realizar cambios complejos en el esquema y manejar la evolución de las particiones.
Dominar técnicas para optimizar el rendimiento de las consultas y la eficiencia del escaneo de datos en conjuntos de datos grandes.
Implementar mecanismos que garanticen la consistencia de los datos, administrar garantías transaccionales y manejar fallos en entornos distribuidos.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a profesionales de datos principiantes que desean adquirir los conocimientos y habilidades necesarios para utilizar eficazmente Apache Iceberg en la gestión de conjuntos de datos a gran escala, garantizar la integridad de los datos y optimizar los flujos de procesamiento de datos.
Al finalizar esta formación, los participantes serán capaces de:
Comprender en profundidad la arquitectura, las características y los beneficios de Apache Iceberg.
Conocer los formatos de tabla, el particionamiento, la evolución del esquema y las capacidades de viaje en el tiempo (time travel).
Instalar y configurar Apache Iceberg en diferentes entornos.
Crear, gestionar y manipular tablas Iceberg.
Comprender el proceso de migración de datos desde otros formatos de tabla a Iceberg.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a profesionales de TI de nivel intermedio que deseen potenciar sus habilidades en arquitectura de datos, gobernanza, computación en la nube y tecnologías Big Data, para gestionar y analizar eficazmente grandes volúmenes de datos con fines de migración dentro de sus organizaciones.
Al finalizar esta formación, los participantes podrán:
Comprender los conceptos fundamentales y los componentes de las distintas arquitecturas de datos.
Obtener un entendimiento integral de los principios de gobernanza de datos y su importancia en entornos regulatorios.
Implementar y gestionar marcos de gobernanza de datos, como DAMA y TOGAF.
Aprovechar las plataformas en la nube para el almacenamiento, procesamiento y gestión eficientes de los datos.
Esta formación en vivo con instructores en <ubicación> (en línea o presencial) está dirigida a ingenieros de datos de nivel intermedio que desean aprender a utilizar Azure Data Lake Storage Gen2 para soluciones eficaces de análisis de datos.
Al finalizar esta formación, los participantes podrán:
Comprender la arquitectura y las características clave de Azure Data Lake Storage Gen2.
Optimizar el almacenamiento y acceso a datos para reducir costos y mejorar el rendimiento.
Integrar Azure Data Lake Storage Gen2 con otros servicios de Azure para análisis y procesamiento de datos.
Desarrollar soluciones mediante la API de Azure Data Lake Storage Gen2.
Solucionar problemas comunes y optimizar las estrategias de almacenamiento.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a desarrolladores que desean utilizar e integrar Spark, Hadoop y Python para procesar, analizar y transformar conjuntos de datos grandes y complejos.
Al finalizar esta capacitación, los participantes serán capaces de:
Configurar el entorno necesario para comenzar a trabajar con big data mediante Spark, Hadoop y Python.
Comprender las características, componentes principales y arquitectura de Spark y Hadoop.
Aprender cómo integrar Spark, Hadoop y Python para el procesamiento de grandes datos.
Explorar las herramientas del ecosistema de Spark (Spark MLlib, Spark Streaming, Kafka, Sqoop, Kafka y Flume).
Construir sistemas de recomendación mediante filtrado colaborativo similares a los de Netflix, YouTube, Amazon, Spotify y Google.
Utilizar Apache Mahout para escalar algoritmos de aprendizaje automático.
Esta capacitación presencial impartida por instructores en Lèon abarca técnicas avanzadas de big data, computación distribuida y aprendizaje automático a gran escala. Está diseñada para profesionales de datos de nivel avanzado que buscan dominar la analítica en tiempo real, la integración de aprendizaje profundo y estrategias robustas de gobernanza de datos.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a profesionales de TI de nivel intermedio que desean tener una comprensión integral de IBM DataStage desde una perspectiva tanto administrativa como de desarrollo, lo que les permitirá gestionar y utilizar esta herramienta de manera eficaz en sus respectivos entornos laborales.
Al finalizar esta formación, los participantes serán capaces de:
Comprender los conceptos básicos de DataStage.
Aprender a instalar, configurar y gestionar entornos de DataStage de manera eficaz.
Conectarse a diversas fuentes de datos y extraer información de forma eficiente desde bases de datos, archivos planos y fuentes externas.
Esta capacitación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a administradores de sistemas de nivel básico a intermedio que deseen implementar, mantener y optimizar clústeres de Spark.
Al finalizar esta capacitación, los participantes podrán:
Instalar y configurar Apache Spark en diversos entornos.
Gestionar los recursos del clúster y monitorear las aplicaciones de Spark.
Optimizar el rendimiento de los clústeres de Spark.
Implementar medidas de seguridad y garantizar la alta disponibilidad.
En esta capacitación en vivo guiada por un instructor en Lèon, los participantes aprenderán a utilizar Python y Spark juntos para analizar Big Data, mientras realizan ejercicios prácticos.
Al finalizar esta capacitación, los participantes podrán:
Aprender a usar Spark con Python para analizar Big Data.
Trabajar en ejercicios que simulan casos del mundo real.
Utilizar diferentes herramientas y técnicas para el análisis de Big Data con PySpark.
Explora la BI de Big Data para agencias gubernamentales en Lèon. Este curso cubre Hadoop, NoSQL, analítica predictiva y herramientas en tiempo real para gestionar flujos de datos vastos y diversos. Aprende sobre detección de fraudes, ciberseguridad y estrategias de ROI para convertir datos no estructurados en activos estratégicos para el éxito de la misión.
En esta formación en vivo impartida por un instructor en Lèon, los participantes aprenderán la mentalidad adecuada para abordar las tecnologías de Big Data, evaluar su impacto en los procesos y políticas existentes e implementar estas tecnologías con el propósito de identificar actividades criminales y prevenir delitos. Se examinarán casos de estudio de organizaciones de fuerzas del orden de todo el mundo para obtener información sobre sus enfoques de adopción, desafíos y resultados.
Al finalizar esta capacitación, los participantes serán capaces de:
Combinar la tecnología de Big Data con los procesos tradicionales de recopilación de datos para reconstruir una historia durante una investigación.
Implementar soluciones industriales de almacenamiento y procesamiento de Big Data para el análisis de datos.
Elaborar una propuesta para la adopción de las herramientas y procesos más adecuados que permitan un enfoque basado en datos para la investigación criminal.
Explora los fundamentos de la programación con Big Data en R, un lenguaje popular en finanzas. Este curso en Lèon cubre la configuración del entorno, MPI para procesamiento paralelo y matrices distribuidas. Aprende a manejar grandes conjuntos de datos, realizar regresión distribuida y aplicar métodos de Monte Carlo de manera eficiente.
Esta capacitación en vivo impartida por un instructor (en línea o presencial) está dirigida a ingenieros de datos, analistas de datos y profesionales del sector que deseen utilizar Databricks y PySpark para construir pipelines de datos escalables y migrar flujos de trabajo SQL existentes.
En Lèon, esta capacitación de cinco días introduce los sistemas de streaming de datos en tiempo real. Cubre los conceptos fundamentales, los patrones de arquitectura y las herramientas de la industria para el procesamiento de datos continuos a gran escala. Los diseñadores, implementan y optimizan canalizaciones de streaming escalables utilizando marcos de trabajo modernos.
Esta capacitación en vivo impartida por un instructor en Lèon está diseñada para administradores de nivel intermedio que buscan desplegar y gestionar Apache NiFi en producción. Los participantes aprenderán a configurar clústeres, diseñar flujos de datos y optimizar el rendimiento mediante laboratorios prácticos y ejercicios basados en escenarios.
Esta capacitación proporciona una introducción práctica para construir flujos de trabajo escalables de procesamiento de datos y aprendizaje automático utilizando PySpark. Los participantes aprenderán cómo Apache Spark opera dentro de ecosistemas modernos de Big Data y cómo procesar eficientemente grandes conjuntos de datos aplicando principios de computación distribuida.
Este curso práctico de tres días se centra en la construcción y optimización de cargas de trabajo de procesamiento de datos eficientes utilizando PySpark, Pandas y Polars en entornos basados en Kubernetes.
Los participantes desarrollarán una comprensión práctica de cómo se ejecutan las aplicaciones de Spark en Kubernetes y cómo las decisiones de configuración a nivel de aplicación influyen en el rendimiento, la escalabilidad, el consumo de recursos y los costos. El curso cubre áreas clave de optimización, incluida la dimensión de ejecutores, la asignación de memoria, la asignación dinámica, las estrategias de particionado, el comportamiento de shuffle, los problemas de archivos pequeños y el procesamiento eficiente de Parquet.
El curso también aborda los desafíos comunes al trabajar con Pandas, como las limitaciones de memoria y los fallos por falta de memoria, e introduce Polars como una alternativa de alto rendimiento para cargas de trabajo de procesamiento de datos seleccionadas. A través de ejercicios prácticos, los participantes diagnosticarán problemas de rendimiento y memoria, compararán diferentes estrategias de configuración y aplicarán técnicas de optimización a escenarios realistas de ETL y aprendizaje automático.
El énfasis durante todo el curso recae en la tomada de decisiones práctica: comprender cómo identificar cuellos de botella, seleccionar la herramienta adecuada, configurar Spark de manera eficiente y equilibrar el rendimiento con el consumo de recursos de infraestructura y los costos.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a ingenieros que deseen configurar e implementar un sistema Apache Spark para procesar grandes volúmenes de datos.
Al finalizar esta formación, los participantes podrán:
Instalar y configurar Apache Spark.
Procesar y analizar conjuntos de datos muy grandes con rapidez.
Comprender las diferencias entre Apache Spark y Hadoop MapReduce, así como conocer cuándo usar cada uno.
Integrar Apache Spark con otras herramientas de aprendizaje automático.
Esta capacitación práctica en Lèon desmitifica Apache Spark, cubriendo RDDs, DataFrames y las APIs de Python/Scala. Los participantes dominarán la implementación en la nube con Databricks, AWS EMR y Glue, adquiriendo habilidades prácticas para realizar tareas efectivas de ingeniería de datos y DevOps en entornos reales.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a personas técnicas que deseen implementar Talend Open Studio for Big Data para simplificar el proceso de lectura y procesamiento de grandes volúmenes de datos.
Al finalizar esta capacitación, los participantes podrán:
Instalar y configurar Talend Open Studio for Big Data.
Conectarse con sistemas de Big Data como Cloudera, HortonWorks, MapR, Amazon EMR y Apache.
Comprender y configurar los componentes de big data y conectores de Open Studio.
Configurar parámetros para generar automáticamente código MapReduce.
Utilizar la interfaz de arrastrar y soltar de Open Studio para ejecutar trabajos de Hadoop.
Objetivo general Dotar a los participantes de las competencias necesarias para diseñar, implementar y utilizar soluciones avanzadas de ciencia de datos enfocadas al procesamiento escalable de información, la analítica de grandes volúmenes y la visualización inteligente. Se busca integrar fundamentos estadísticos, técnicas de machine learning, arquitecturas de datos modernas y estrategias de comunicación efectiva de resultados para respaldar la toma de decisiones organizacionales.
Competencias a desarrollar
Al finalizar la capacitación, el participante será capaz de:
Comprender los fundamentos de la analítica escalable y su aplicación en contextos empresariales.
Diseñar esquemas de ingesta, procesamiento y organización de datos para diversas fuentes y volúmenes de información.
Aplicar principios de Big Data y procesamiento distribuido para realizar análisis eficientes de datos a gran escala.
Construir y optimizar pipelines de datos garantizando calidad, rendimiento y escalabilidad.
Utilizar técnicas de estadística aplicada y machine learning para el análisis, modelado y predicción sobre grandes conjuntos de datos.
Evaluar el desempeño de modelos analíticos considerando la validación, el sesgo, el overfitting y el drift.
Diseñar visualizaciones, tableros y narrativas analíticas que comuniquen hallazgos de manera clara y útil para la toma de decisiones.
Integrar técnicas avanzadas de ciencia de datos para resolver problemas complejos en escenarios reales.
Leer más...
Última Actualización:
Reseñas (6)
Un viaje por el mundo de Spark: un curso muy intenso. DSL, Spark SQL, particionamiento versus agrupación para mí.
Georgiana Elisabeta
Curso - Apache Spark Fundamentals
Traducción Automática
Gobernanza de datos
Ignacio Jimenez - Contraloria General de la Republica
Curso - Data Warehousing: Concepts, Design, and Implementation
los ejercicios y la resolucion de problemas
Mario Humberto Serrano Gutierrez - Hipodromo de Agua Caliente
Curso - Greenplum Architecture and Data Modeling
Ejercicios prácticos. La clase debería haber durado 5 días, pero los 3 días fueron útiles para aclarar muchas de las preguntas que tenía al trabajar con NiFi.
James - BHG Financial
Curso - Apache NiFi for Administrators
Traducción Automática
La capacidad del formador de alinear el curso con los requisitos de la organización, y no solo proporcionarlo por el mero hecho de impartirlo.
Masilonyane - Revenue Services Lesotho
Curso - Big Data Business Intelligence for Govt. Agencies
Traducción Automática
El hecho de poder llevar con nosotros la mayoría de la información/curso/presentación/ejercicios realizados, para poder revisarlos y tal vez volver a hacer lo que no entendimos la primera vez o mejorar lo que ya hicimos.
Cursos de Fin de Semana de Big Data en Lèon, Capacitación por la Tarde de Big Data en Lèon, Big Data con instructor en Lèon, Instructor de Big Data en Lèon, Clases Particulares de Big Data en Lèon, Cursos de Formación de Big Data en Lèon, Big Data en sitio en Lèon, Big Data boot camp en Lèon, Cursos por la Tarde de Big Data en Lèon, Capacitación de Fin de Semana de Big Data en Lèon, Cursos Privados de Big Data en Lèon, Capacitador de Big Data en Lèon, Big Data coaching en Lèon, Clases de Big Data en Lèon