NobleProg ofrece cursos de capacitación en Apache Spark en Lèon, brindando a los profesionales de la región la oportunidad de actualizar sus competencias. Al situarse en esta zona estratégica, nuestros programas permiten a los equipos locales adquirir habilidades prácticas y certificadas. Esta inversión en formación fomenta la innovación y el crecimiento profesional, fortaleciendo el talento humano en Apache Spark.
Los cursos presenciales en línea o en sitio, impartidos por un instructor, de formación práctica en Apache Spark demuestran, mediante ejercicios prácticos, cómo Spark se integra en el ecosistema de Big Data y cómo utilizarlo para el análisis de datos.
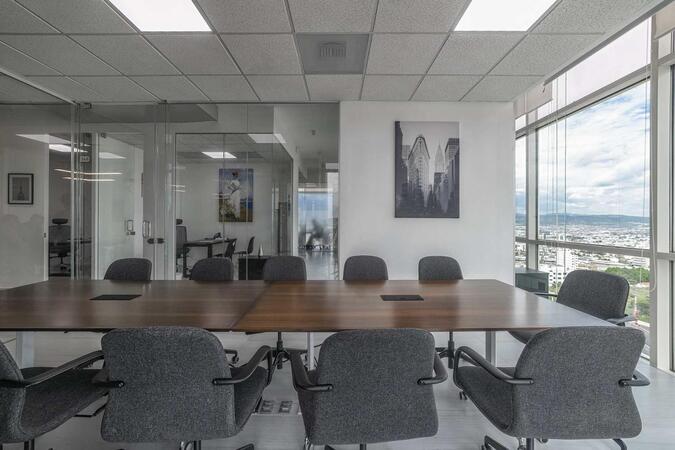
La formación en Apache Spark está disponible como "formación en vivo en línea" o "formación en vivo en sitio". La formación en vivo en línea (también conocida como "formación remota en vivo") se lleva a cabo a través de un escritorio remoto interactivo. La formación en vivo en sitio puede realizarse localmente en las instalaciones del cliente en Lèon o en los centros de formación corporativa de NobleProg en Lèon.
NobleProg — Tu proveedor local de formación
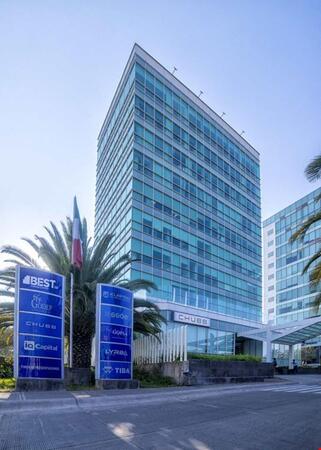
Leòn - Torre San Mateo
Blvd. Campestre 2502, Leòn, México
Ubicada en la Zona Dorada de Leon Gto.
En autobús público
El transporte público de León es el sistema SIT/Optibús. La ciudad publica información actualizada sobre las rutas y los horarios a través de su Departamento de Movilidad.
Desde el centro de León: una opción práctica es viajar hacia la Terminal San Jerónimo y luego continuar hacia la zona de Campestre.
El Blvd. Campestre cuenta con servicio de rutas locales; por ejemplo, la ruta L-02 recorre el Boulevard Campestre y conecta con el Centro Histórico y San Jerónimo.
Para el tramo final, es posible que tenga que caminar unos minutos desde la parada más cercana hasta el n.º 2502.
Esta formación en vivo dirigida por instructores en <ubic> (en línea o presencial) está orientada a científicos de datos e ingenieros de nivel intermedio que desean utilizar Google Colab y Apache Spark para el procesamiento y análisis de big data.
Al finalizar esta formación, los participantes podrán:
Configurar un entorno de big data utilizando Google Colab y Spark.
Procesar y analizar grandes conjuntos de datos de forma eficiente con Apache Spark.
Visualizar big data en un entorno colaborativo.
Integrar Apache Spark con herramientas basadas en la nube.
Esta formación en vivo con instructor en Lèon cubre la plataforma Stratio, enfocándose en los módulos Rocket e Intelligence con PySpark. Los participantes dominarán la ingesta, transformación y analítica avanzada de datos, adquiriendo habilidades prácticas en bucles, UDFs y flujos de trabajo de datos empresariales.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a desarrolladores que desean utilizar e integrar Spark, Hadoop y Python para procesar, analizar y transformar conjuntos de datos grandes y complejos.
Al finalizar esta capacitación, los participantes serán capaces de:
Configurar el entorno necesario para comenzar a trabajar con big data mediante Spark, Hadoop y Python.
Comprender las características, componentes principales y arquitectura de Spark y Hadoop.
Aprender cómo integrar Spark, Hadoop y Python para el procesamiento de grandes datos.
Explorar las herramientas del ecosistema de Spark (Spark MLlib, Spark Streaming, Kafka, Sqoop, Kafka y Flume).
Construir sistemas de recomendación mediante filtrado colaborativo similares a los de Netflix, YouTube, Amazon, Spotify y Google.
Utilizar Apache Mahout para escalar algoritmos de aprendizaje automático.
Esta capacitación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a administradores de sistemas de nivel básico a intermedio que deseen implementar, mantener y optimizar clústeres de Spark.
Al finalizar esta capacitación, los participantes podrán:
Instalar y configurar Apache Spark en diversos entornos.
Gestionar los recursos del clúster y monitorear las aplicaciones de Spark.
Optimizar el rendimiento de los clústeres de Spark.
Implementar medidas de seguridad y garantizar la alta disponibilidad.
En esta capacitación en vivo guiada por un instructor en Lèon, los participantes aprenderán a utilizar Python y Spark juntos para analizar Big Data, mientras realizan ejercicios prácticos.
Al finalizar esta capacitación, los participantes podrán:
Aprender a usar Spark con Python para analizar Big Data.
Trabajar en ejercicios que simulan casos del mundo real.
Utilizar diferentes herramientas y técnicas para el análisis de Big Data con PySpark.
Esta capacitación en vivo impartida por un instructor (en línea o presencial) está dirigida a ingenieros de datos, analistas de datos y profesionales del sector que deseen utilizar Databricks y PySpark para construir pipelines de datos escalables y migrar flujos de trabajo SQL existentes.
Esta capacitación proporciona una introducción práctica para construir flujos de trabajo escalables de procesamiento de datos y aprendizaje automático utilizando PySpark. Los participantes aprenderán cómo Apache Spark opera dentro de ecosistemas modernos de Big Data y cómo procesar eficientemente grandes conjuntos de datos aplicando principios de computación distribuida.
Este curso práctico de tres días se centra en la construcción y optimización de cargas de trabajo de procesamiento de datos eficientes utilizando PySpark, Pandas y Polars en entornos basados en Kubernetes.
Los participantes desarrollarán una comprensión práctica de cómo se ejecutan las aplicaciones de Spark en Kubernetes y cómo las decisiones de configuración a nivel de aplicación influyen en el rendimiento, la escalabilidad, el consumo de recursos y los costos. El curso cubre áreas clave de optimización, incluida la dimensión de ejecutores, la asignación de memoria, la asignación dinámica, las estrategias de particionado, el comportamiento de shuffle, los problemas de archivos pequeños y el procesamiento eficiente de Parquet.
El curso también aborda los desafíos comunes al trabajar con Pandas, como las limitaciones de memoria y los fallos por falta de memoria, e introduce Polars como una alternativa de alto rendimiento para cargas de trabajo de procesamiento de datos seleccionadas. A través de ejercicios prácticos, los participantes diagnosticarán problemas de rendimiento y memoria, compararán diferentes estrategias de configuración y aplicarán técnicas de optimización a escenarios realistas de ETL y aprendizaje automático.
El énfasis durante todo el curso recae en la tomada de decisiones práctica: comprender cómo identificar cuellos de botella, seleccionar la herramienta adecuada, configurar Spark de manera eficiente y equilibrar el rendimiento con el consumo de recursos de infraestructura y los costos.
Esta formación en vivo impartida por un instructor en Lèon (en línea o presencial) está dirigida a ingenieros que deseen configurar e implementar un sistema Apache Spark para procesar grandes volúmenes de datos.
Al finalizar esta formación, los participantes podrán:
Instalar y configurar Apache Spark.
Procesar y analizar conjuntos de datos muy grandes con rapidez.
Comprender las diferencias entre Apache Spark y Hadoop MapReduce, así como conocer cuándo usar cada uno.
Integrar Apache Spark con otras herramientas de aprendizaje automático.
Esta capacitación práctica en Lèon desmitifica Apache Spark, cubriendo RDDs, DataFrames y las APIs de Python/Scala. Los participantes dominarán la implementación en la nube con Databricks, AWS EMR y Glue, adquiriendo habilidades prácticas para realizar tareas efectivas de ingeniería de datos y DevOps en entornos reales.
Leer más...
Última Actualización:
Reseñas (4)
Un viaje por el mundo de Spark: un curso muy intenso. DSL, Spark SQL, particionamiento versus agrupación para mí.
Georgiana Elisabeta
Curso - Apache Spark Fundamentals
Traducción Automática
Me gustó que fuera práctico. Amé aplicar el conocimiento teórico con ejemplos prácticos.
Aurelia-Adriana - Allianz Services Romania
Curso - Python and Spark for Big Data (PySpark)
Traducción Automática
El hecho de poder llevar con nosotros la mayoría de la información/curso/presentación/ejercicios realizados, para poder revisarlos y tal vez volver a hacer lo que no entendimos la primera vez o mejorar lo que ya hicimos.
Raul Mihail Rat - Accenture Industrial SS
Curso - Python, Spark, and Hadoop for Big Data
Traducción Automática
Tener sesiones prácticas / asignaciones
Poornima Chenthamarakshan - Intelligent Medical Objects
Cursos de Fin de Semana de Spark en Lèon, Capacitación por la Tarde de Spark en Lèon, Apache Spark con instructor en Lèon, Spark boot camp en Lèon, Spark coaching en Lèon, Cursos por la Tarde de Spark en Lèon, Capacitación de Fin de Semana de Apache Spark en Lèon, Cursos Privados de Apache Spark en Lèon, Clases de Apache Spark en Lèon, Apache Spark en sitio en Lèon, Instructor de Apache Spark en Lèon, Clases Particulares de Spark en Lèon, Capacitador de Spark en Lèon, Cursos de Formación de Spark en Lèon